

10月21日·周三·AI内容投毒与创作边界争议
10月21日·周三·AI工具和资源推荐
AI智库导航-aiguide.cc为您提供最新的AI新闻资讯和最新的AI工具推荐,在这里你可以获得用于营销的AI聊天机器人、AI在商业管理中的应用、用于数据分析的AI工具、机器学习模型、面向企业的AI解决方案、AI在商业客户服务中的应用、AI和自动化工具等。
「投毒」LLM新招:发布虚假数据,等着被AI引用
一篇来自 Peec AI 团队的实战分享揭露了一个令人警觉的现象:通过在网络上发布精心设计的「虚构统计数据」,可以在极短时间内被多个主流 LLM 抓取并作为权威来源引用。文章作者分享了具体的操作手法——选择 AI 容易引用的话题领域,制造看似合理的数据图表,发布后等待数日即可在 ChatGPT、Perplexity 等工具的回复中看到自己的「假数据」赫然在列。这一策略本质上是对 LLM 训练数据收集流程和 RAG 检索机制的双重利用。事件引发了关于 AI 信息源可信度、对抗性数据污染(data poisoning)以及品牌如何在 LLM 时代构建数字声誉的广泛讨论。
来源:Hacker News
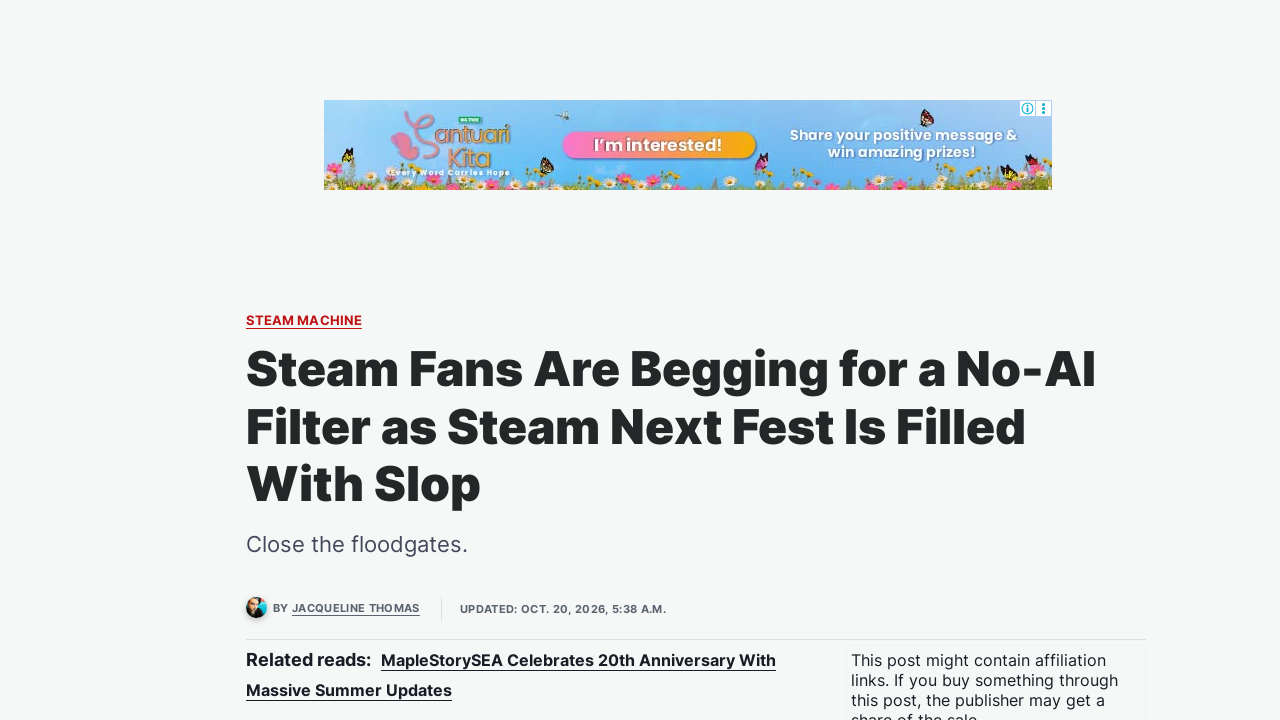
Steam 玩家呼吁「无 AI」过滤,Next Fest 沦为 Vibecoder 垃圾场
Steam 平台正面临一场由 AI 生成内容引发的玩家信任危机。在近日开幕的 Next Fest 游戏节上,大量由所谓的「Vibecoder」(用 AI 辅助甚至全 AI 生成方式快速产出游戏的开发者)上传的 demo 涌入商店页面,引发玩家社区强烈反弹。许多用户集体请愿,要求 Valve 尽快上线「No AI」筛选标签,让消费者能够一键过滤掉 AI 生成的游戏作品。这一现象折射出当前 AI 工具门槛降低带来的内容供给过载问题——任何人都能在数小时内用 Cursor、Claude 等工具拼凑出一个 Steam 页面,对独立开发者和玩家体验都造成冲击。事件也再次引发关于 AI 生成内容是否应被强制标识的讨论。
来源:Hacker News
当 AI 学会写作:关于「人味」的边界正在重新定义
博客作者 Boltzmann Kunov 发表了一篇关于「AI 写作」的长文,引发开发者社区热议。文章从一个尖锐的问题切入:在 LLM 越来越擅长模仿人类文风的今天,我们究竟该如何定义「人写的」文字?作者认为,过去我们常以「文笔好」「逻辑清晰」来区分优质内容,但这些恰恰是 AI 最擅长的领域,真正稀缺的反而是「有立场」「有瑕疵」「有真实经历痕迹」的个人表达。文章呼吁写作者放弃与 AI 在「流畅度」维度的竞争,转而深耕于个人视角、独特经验和真实判断。这一观点与近期出版业、教育界对 AI 生成内容的反思形成呼应。
来源:Hacker News
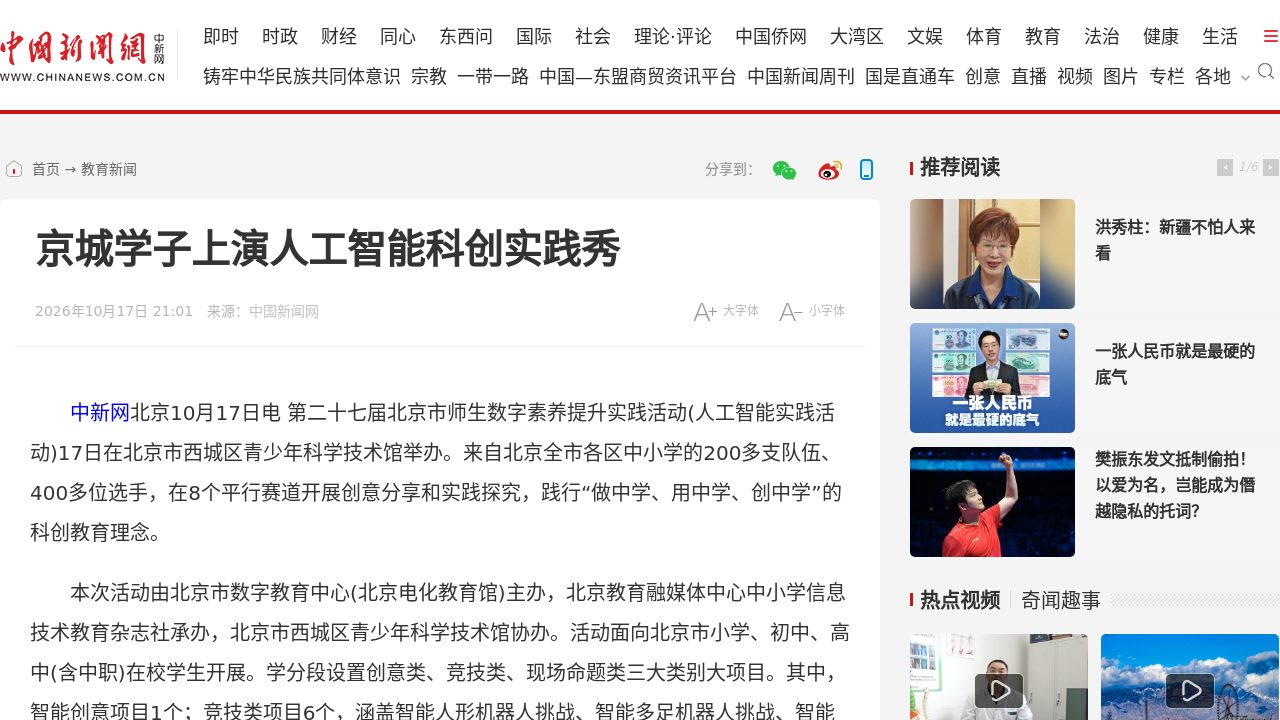
京城学子「玩转」AI:人工智能科创实践秀上新一批年轻面孔
据中新网报道,北京多所中小学近日集中展示了一批学生主导的人工智能科创项目,覆盖智能机器人、机器视觉、AI 传统文化复原等多个方向。此次展示的一大亮点是越来越多低龄学生能够独立完成从模型搭建到代码实现的全流程,部分高年级作品甚至引入了大语言模型 API 来增强交互能力。一线教育工作者表示,随着国产大模型在中小学生群体中普及,AI 编程教育的「准入门槛」正在快速下降,从过去的图形化编程直接跃迁到 Python + 主流 LLM 的组合。这一趋势与全国中小学 AI 教育进校园的政策形成共振,或将改变未来科技人才的早期培养路径。
来源:密塔搜索
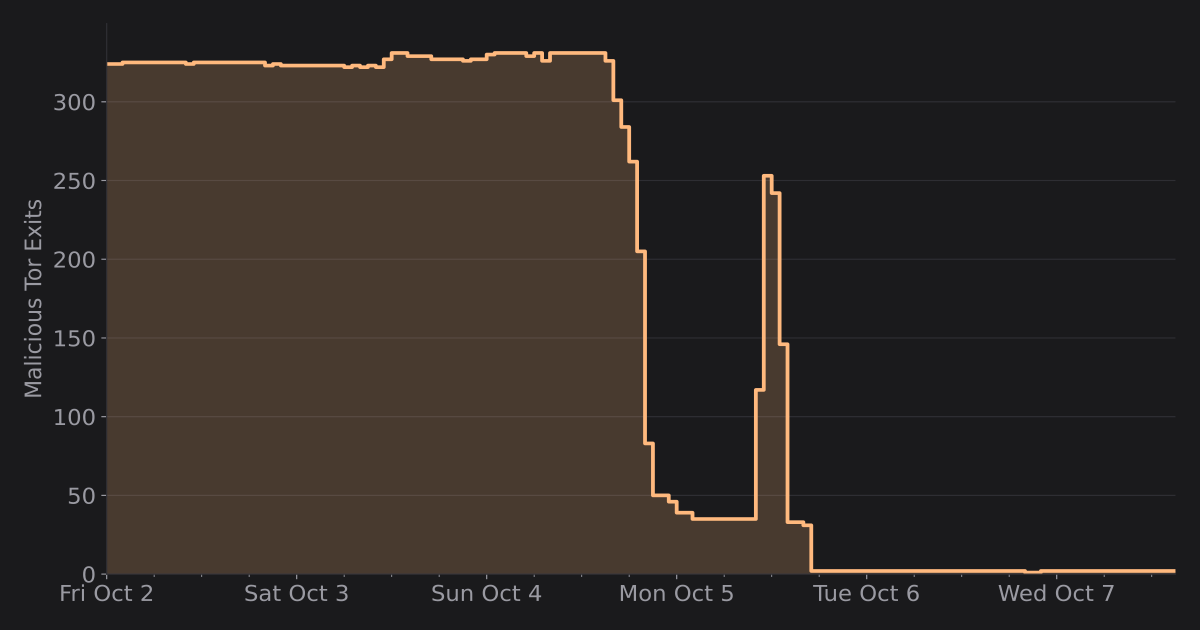
300+ 恶意 Tor 出口节点被集中下线:匿名网络治理的「民间战役」
安全研究员 Kabal 在博客中详细记录了自己如何在数月时间内推动 300 多个可疑 Tor 出口节点退出网络的过程。这些节点被发现存在 SSL 中间人攻击、流量重定向等恶意行为,可能导致用户的明文凭证和浏览内容被劫持。作者通过自动化扫描、收集证据并向相关运营商和目录维护者报告,最终促成了大规模下线。这一事件揭示了 Tor 网络长期面临的安全治理挑战——尽管项目方一直致力于识别和清除恶意 relay,但在 AI 爬虫滥用和加密货币驱动的灰色产业背景下,恶意节点的注册速度仍然远快于清理速度。文章也提醒开发者,Tor 网络绝不等同于「绝对匿名」。
来源:Hacker News
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章

暂无评论...

AI全网资源导航每日收集国内外热点AI/人工智能/工具/模型/框架以及最新的AI学习资料/课程等,在这个全新的AI时代,助力每一个人,赋能每一个具体业务场景,与所有人一起努力向前!
