

10月23日·周五·LLM验证与Agent安全升温
10月23日·周五·AI工具和资源推荐
AI智库导航-aiguide.cc为您提供最新的AI新闻资讯和最新的AI工具推荐,在这里你可以获得用于营销的AI聊天机器人、AI在商业管理中的应用、用于数据分析的AI工具、机器学习模型、面向企业的AI解决方案、AI在商业客户服务中的应用、AI和自动化工具等。
LLM正把形式化软件验证推向更大规模
形式化软件验证长期受制于专业人员稀缺、规格编写成本高,以及错误定位所需的大量试错。Anthropic这项研究释放的关键信号是:LLM不仅能生成代码,也能参与把自然语言需求转化为规格、拆解证明义务并辅助检查失败路径,从而扩大可验证软件的覆盖范围。对AI工程而言,这意味着模型能力正从“写出可运行代码”迈向“提供可审计的正确性证据”。不过,验证器最终裁定结果,模型生成的证明仍需依赖可信内核;真正决定落地价值的,是证明能否复现、错误能否追踪,以及在安全关键系统中能否形成稳定的人机协作流程。
来源:Hacker News
NVIDIA发布OpenShell,为AI Agent车队提供安全运行时
当AI Agent从单次对话走向自主执行,runtime必须处理文件系统、网络、凭证、工具权限和跨Agent协作等高风险边界。NVIDIA发布OpenShell,将其定位为面向autonomous agent fleets的安全、私密运行时,重点回应模型无法被完全信任、外部工具可能产生副作用等问题。对企业而言,它的意义在于把Agent安全从prompt约束前移到执行层,推动权限控制、环境隔离、审计与恢复成为基础设施,而不是每个团队临时拼接的脚本。实际采用时仍需关注其威胁模型是否覆盖真实场景、策略能否细粒度配置,以及与现有容器、身份和可观测性系统是否兼容。
来源:Hacker News
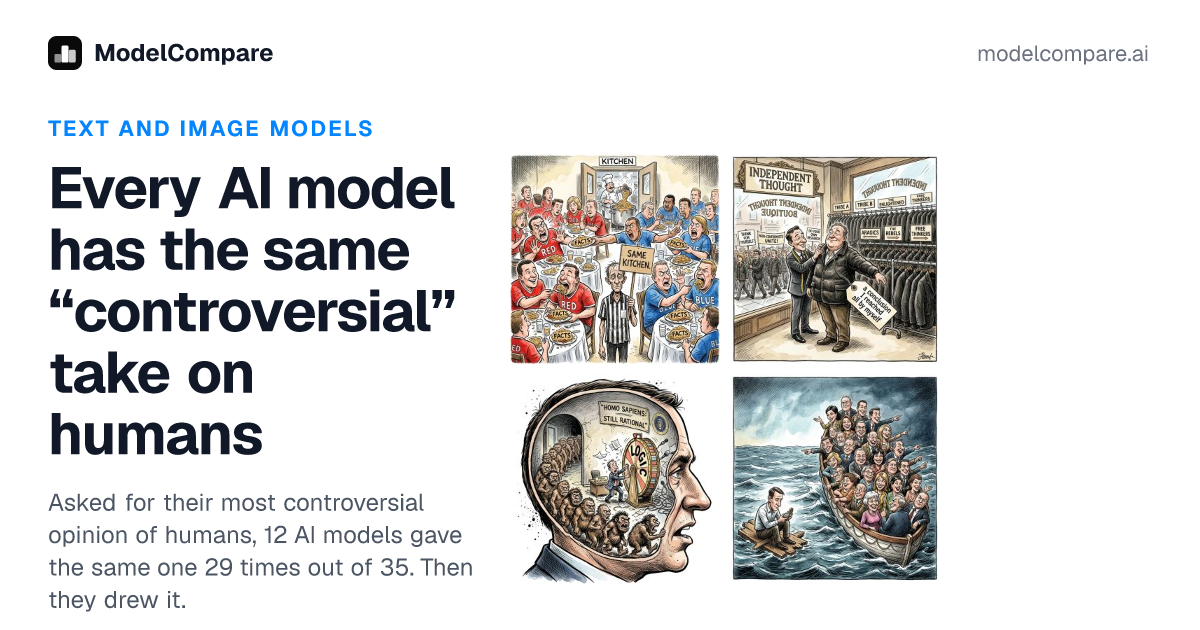
不同AI models如何看人类?相似答案背后藏着什么
ModelCompare比较了多个主流AI models对人类的“争议性判断”,发现它们在不少问题上给出了高度相似的结论。表面上看,这像是模型形成了共同观点;更谨慎的解释是,主流模型可能共享训练语料、价值偏好、RLHF目标和相似的提问框架,因此在敏感议题上出现收敛。对产品团队而言,这种一致性会直接影响AI companion、客服和决策支持的可信度:输出越顺理成章,越需要检查其依据、立场偏差与利益冲突。真正有价值的测试,不应只问模型“怎么看人”,还应改变措辞、文化语境和角色设定,观察其结论是否稳定、透明且可证伪。
来源:Hacker News
Today AI累计融资超2亿美元,长期个人AI仍处早期
据报道,Today AI累计融资已超过2亿美元,目标是打造能够长期理解用户、并在恰当时机主动提供帮助的个人AI。产品团队透露,相关研究方法、测试场景和阶段性成果将逐步开放,也希望开发者、研究者与用户共同检验;与此同时,其坦诚当前体验仍处于早期,交互流畅度、功能提示和操作顺手程度都有待打磨。这条消息的看点不只是“个人AI”概念再度升温,而是竞争开始从单轮问答转向持续建模、记忆管理和主动服务。后续应重点观察隐私授权、记忆准确性、跨场景迁移,以及系统在不确定时能否避免误判。
来源:密塔搜索
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章

暂无评论...

AI全网资源导航每日收集国内外热点AI/人工智能/工具/模型/框架以及最新的AI学习资料/课程等,在这个全新的AI时代,助力每一个人,赋能每一个具体业务场景,与所有人一起努力向前!
